CCF- BDCI 感知赛事解题思路
模型
大方向 | 具体优化项 | 介绍 |
预训练模型 | 使用预训练模型 | 使用官方预训练的模型进行训练 |
冻结网络层 | 使用预训练模型时冻结部分网络层,再进行finetune | |
前处理 | Object Sample数据增强 | 训练代码中默认开启Object Sample数据增强,开发者可以调试Object Sample的各项参数,例如有针对性地增加某种类别目标的采样数量,以此提升该类别的检测效果 |
提升bev空间分辨率 | 训练代码中voxel_size=0.2m,降采样down_ratio为4,表示输入给head的bev特征图中每个像素的实际尺寸为0.8m*0.8m 开发者可以提升降采样down_ratio为2(或者降低voxel_size为0.1m),就可以提升BEV特征图的分辨率(每个像素的实际尺寸为0.4m*0.4m),可有效提升小目标的检测效果。 注意:这种做法会导致模型推理耗时增加。 | |
动态体素化 | 现在使用的是hard体素化,每个pillar中点数是固定的 使用动态体素化可以保留所有点的信息,效果会更好 但paddle3d目前不支持动态体素化,需要参考mmdetection3d的实现 注意:Dynamic Voxelization, DynamicScatter算子 | |
模型网络结构 | 体素格式 | pillar + 2d voxel --> voxels + 3d sparse conv 使用configs/centerpoint/centerpoint_voxels_010voxel_apolloscape.yml |
backbone  | ||
模型轻量化 |
| |
损失函数 | 新的损失函数 | 添加新的损失函数:
|
超参数 | batch_size | 一般来说,batch size越大模型效果越好 |
epochs | 在一定范围内,epochs越大拟合程度越好;但epochs太大会有过拟合的风险 | |
学习率 | 决定了模型参数的更新速度 | |
后处理 | NMS | 当前centerpoint仅在自己的类别内进行NMS,会出现自行车框和行人框重叠度高的问题 可以将输出结果再过一遍NMS,此时进行类间NMS,可提升精度 |
降采样 |
| |
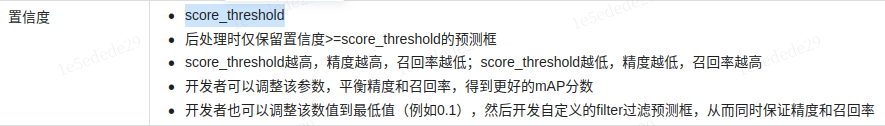
置信度 |
| |
尺寸调整 |
| |
过滤点云数量较少的目标 |
| |
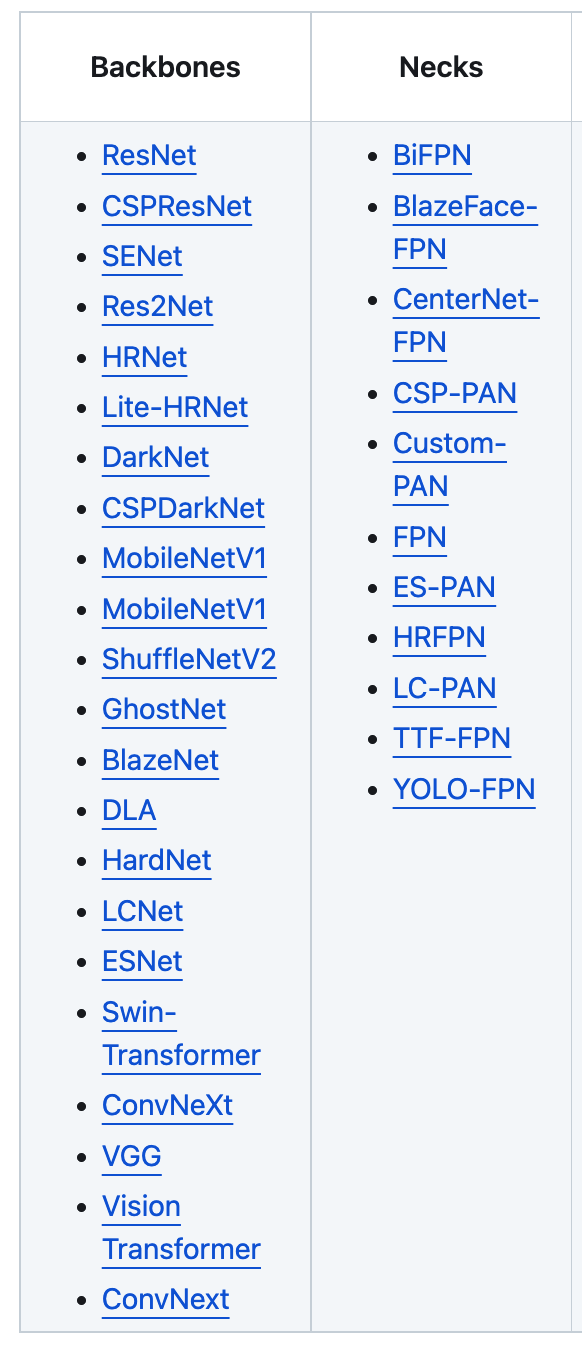
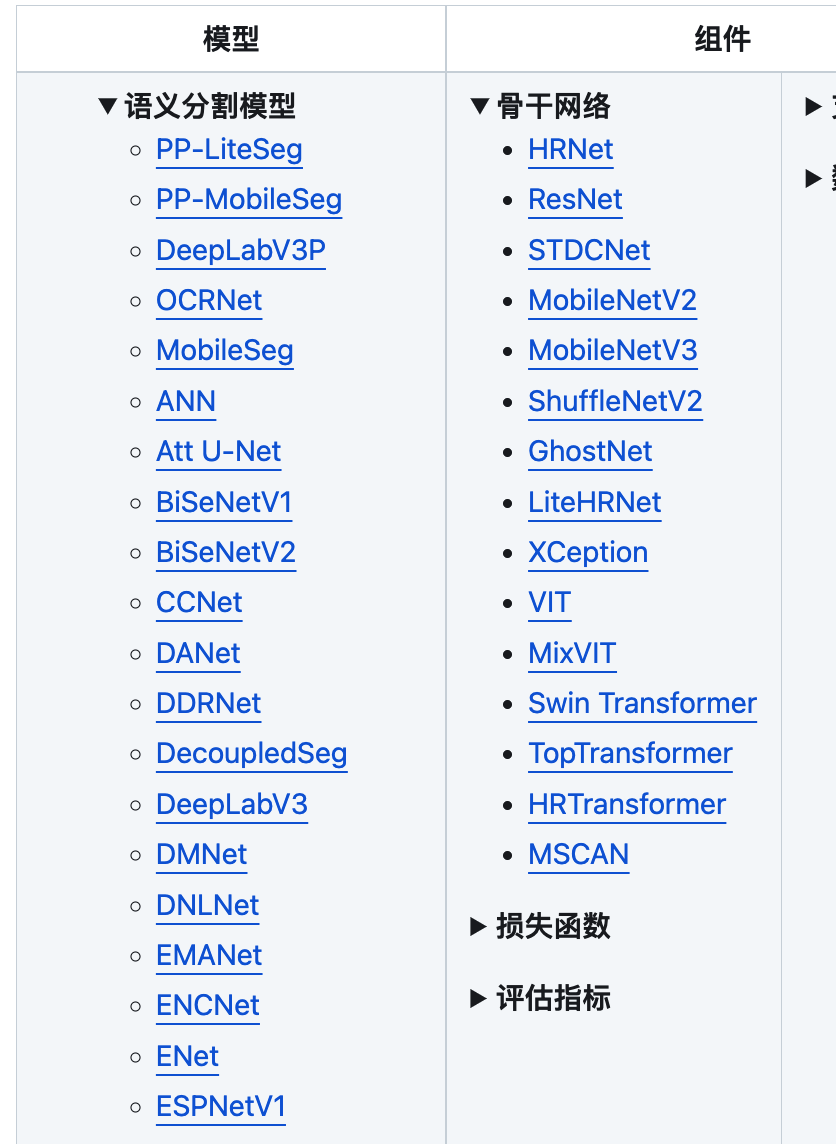
使用新的点云检测模型 | 替换centerpoint使用新的模型 |
|
感知后处理
针对lidar_detection检测完之后拿到目标做后处理,核心思想是首先保证高recall,然后进一步通过过滤降低误检。
保证高recall的方法:适当降低检测置信度,提升recall,
多目标跟踪分数分析
评测分数参考:https://apollo.baidu.com/community/article/1167
总体数据分析
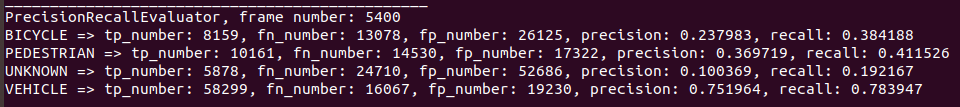
从所有评测数据的准召率上看,VEHICLE指标较高。BICYCLE,PEDESTRIAN的准召率指标较低,主要原因是fn(漏检)和fp(误检)引起的,且fp > fn。。
PEDESTRIAN
分析某个序列,tracking指标如下。其中pedestrian分数较低。针对此类分析。
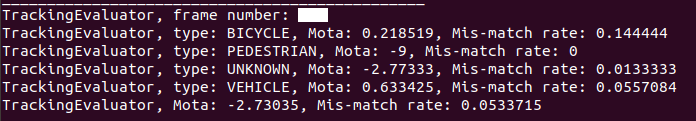
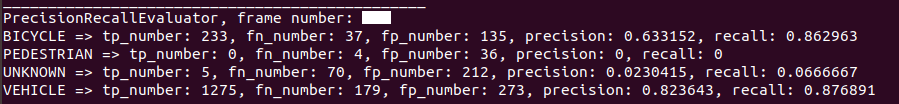
通过tracking日志可以找到相应的数量。
- 行人gt有4个。检测结果中fn 4个,fp 36个,mismatch数量为0。mota = 1 - (4 + 36 + 0) / 4 = -9;
- 行人跟踪评测的低分的原因:
- 误检,第一重要原因
- 漏检,第二重要原因
可视化分析pedestrian:
类别 | fn【漏检】 | fp【误检】 | 原因分析 |
pedestrian 【橙色的为fn,蓝色的为fp】 | 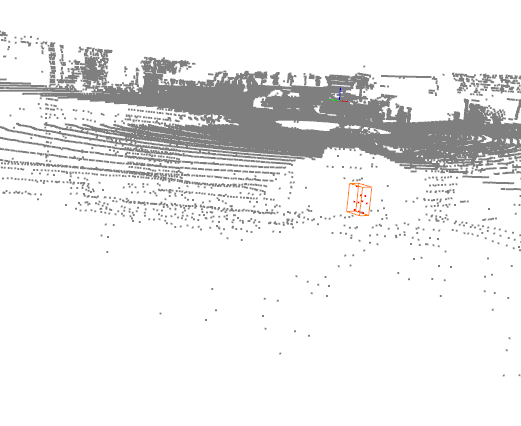 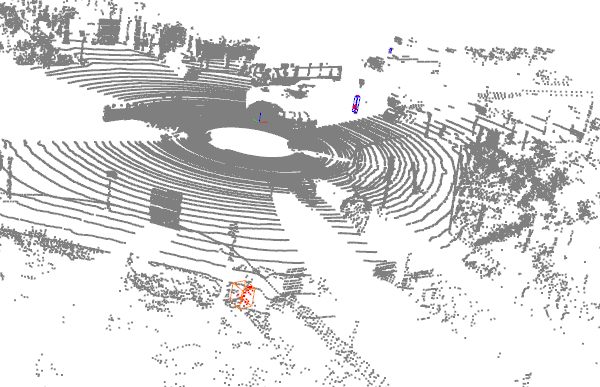 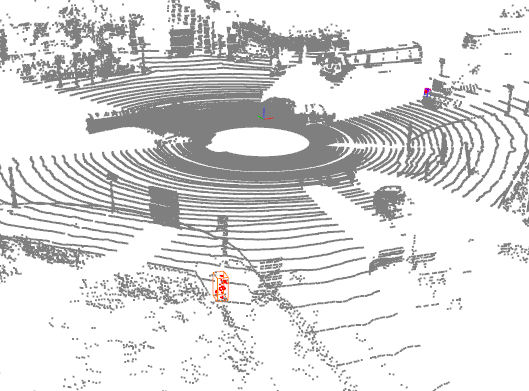 | 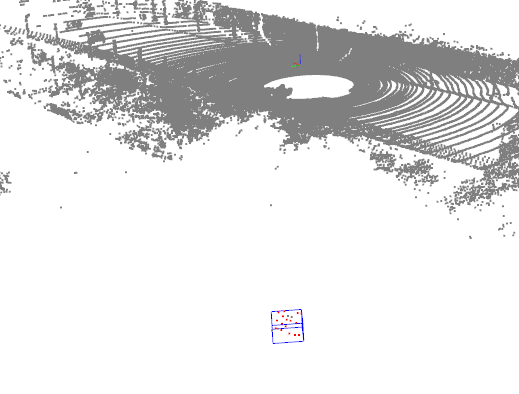 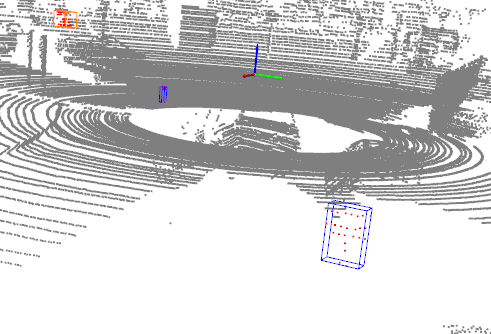 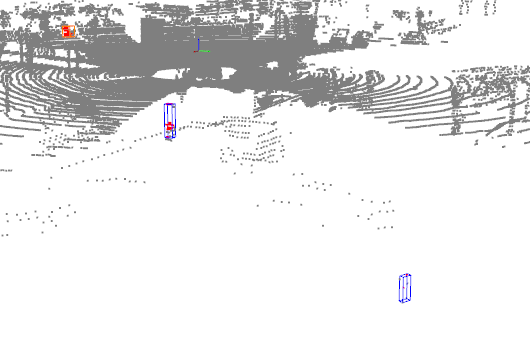 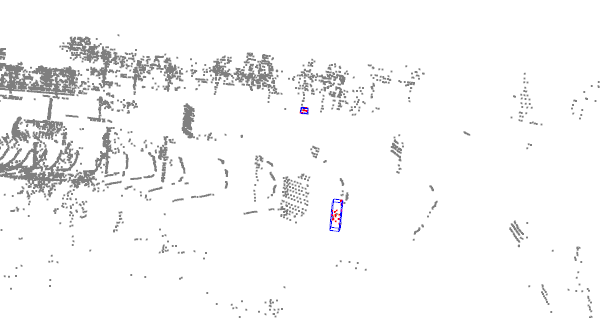 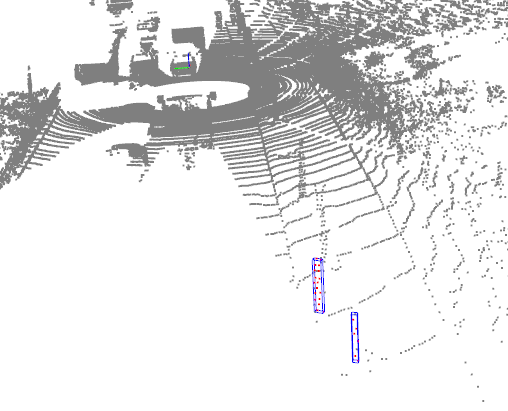 | 1.行人点云特征不清晰,增加模型识别难度。导致漏检; 2.某些点云目标的长、宽、高等与行人接近,导致误检; 3.centerpoint模型没有在apolloscape数据集上训练,泛化能力不够好。 |
BICYCLE
分析序列,tracking评测指标如下。
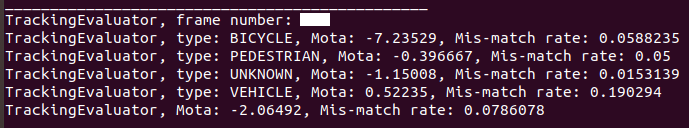
通过tracking日志,对bicycle类别分析。自行车gt数量为51,fn为14,fp为403,mismatch数量为3。mota = 1 - (14 + 403 + 3)/51 = -7.23529。从数据上看mota分数低的主要原因:
- 误检数量太多。第一重要原因;
- 漏检数量较高。第二原因;
- mismatch数量为3。第三原因。
可视化分析BICYCLE:
类别 | fn【漏检】 | fp【误检】 | 原因分析 |
BICYCLE 【靛蓝为fn,绿色为fp】 | 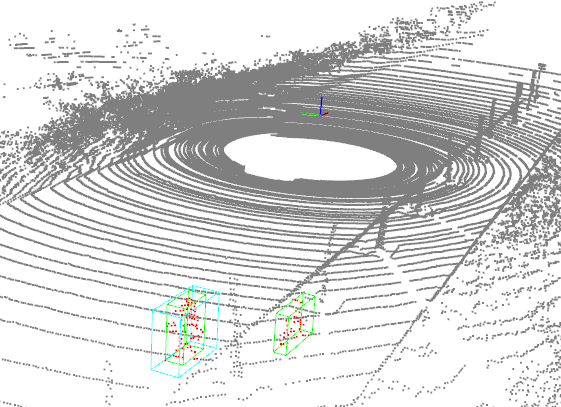 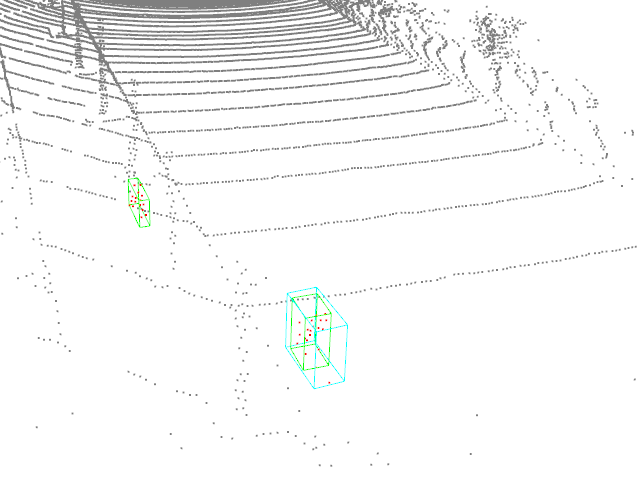 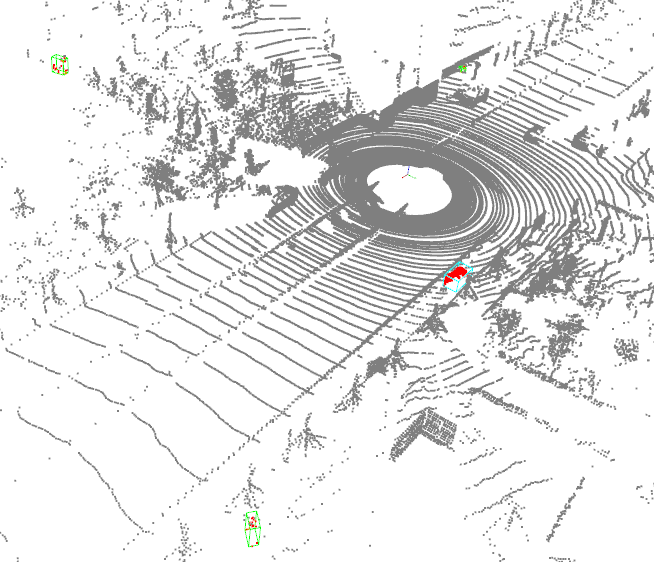 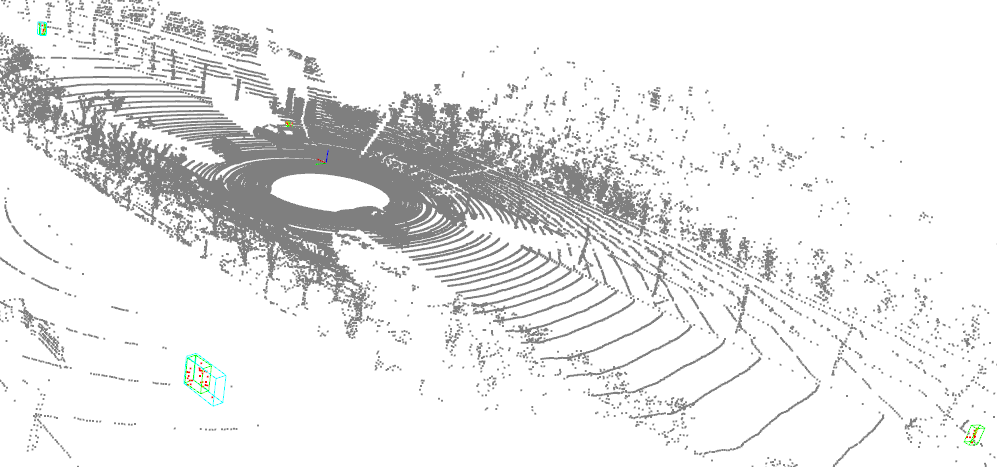 | 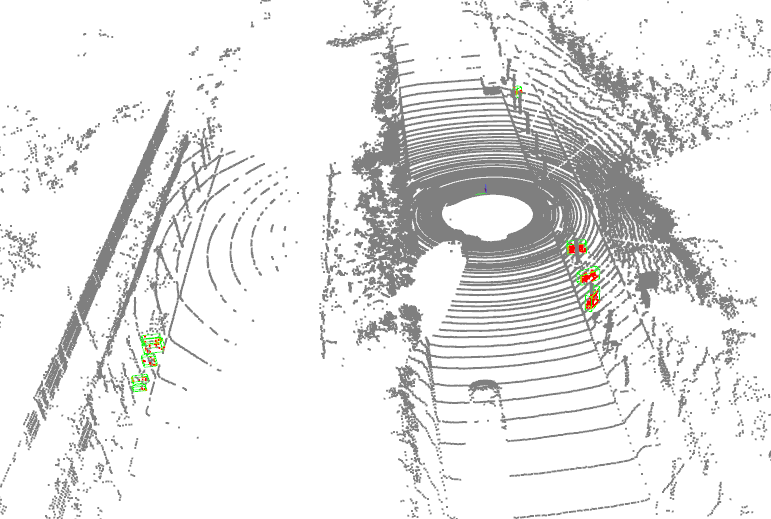 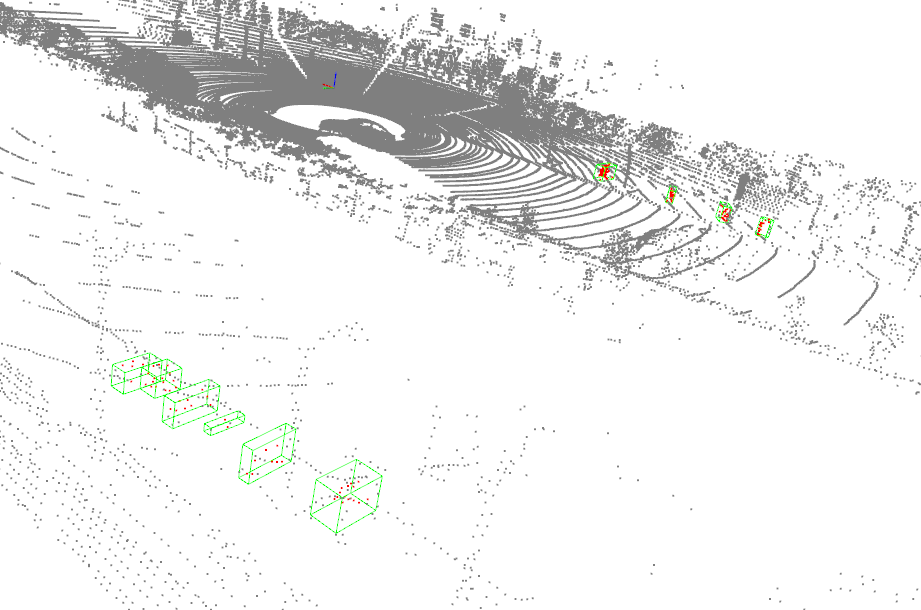 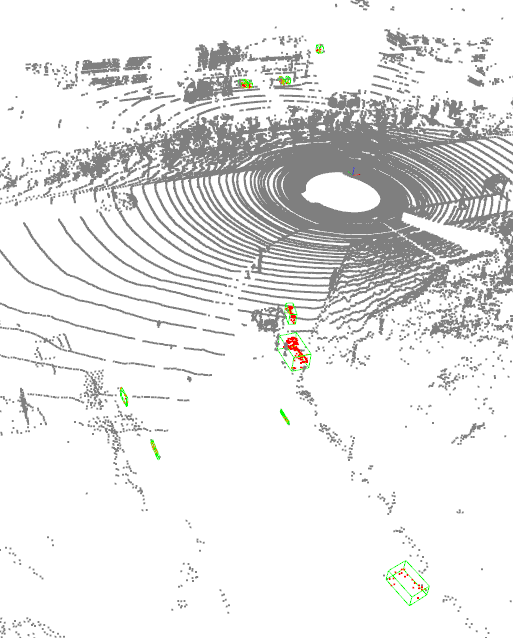 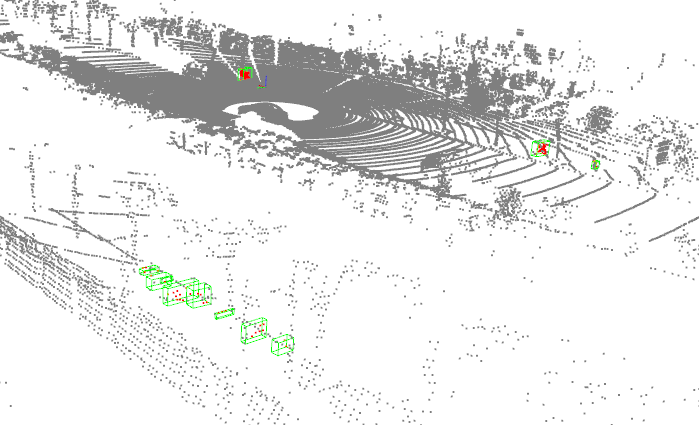 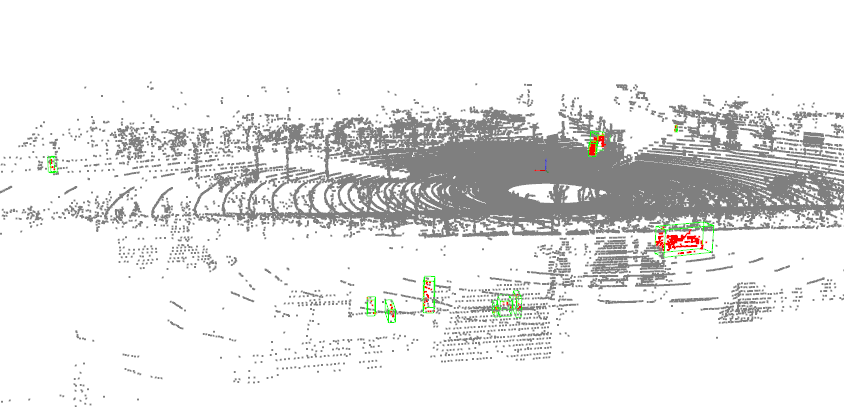 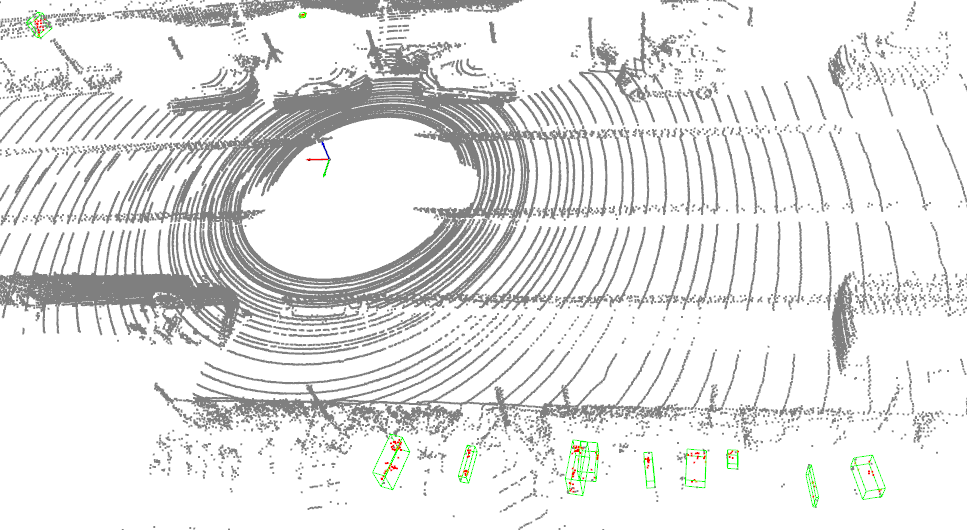 | 1.部分bicycle点云的几何特征不明显,导致漏检; 2.模型在apolloscape下泛化能力有限,导致误检; 3.马路两旁有很多点云几何特征接近bicycle,导致误检;(没有图像,无法检查这些点云是什么) |
多目标跟踪提升思路
多目标跟踪指标提升,这里针对MOTA指标做提升。评测数据共有三类:BICYCLE,PEDESTRIAN,VEHICLE。其中车辆类别的mota指标较高,从可视化看,车辆检测与跟踪效果较好(示例图如下,蓝色为gt,绿色为dt),暂不再进一步优化。
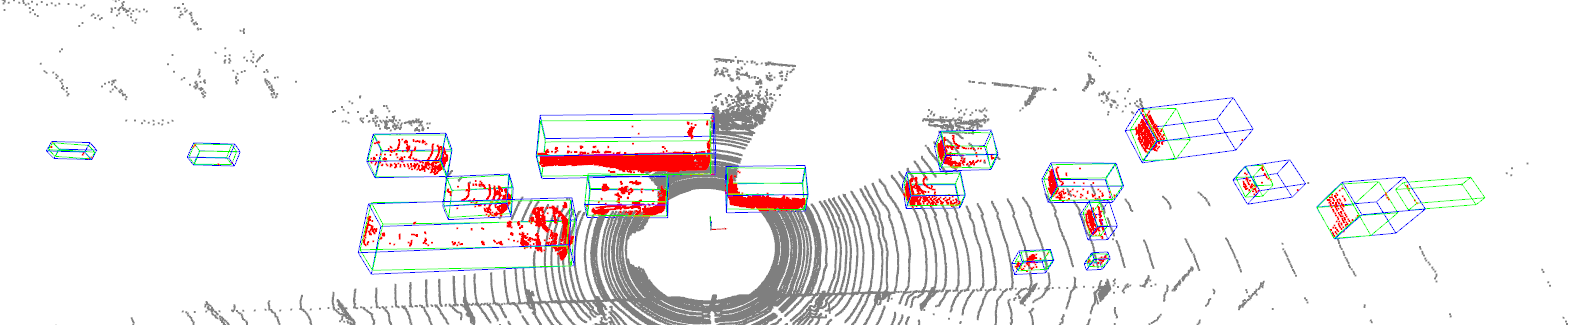
针对BICYCLE,PEDESTRIAN这两类的优化思路如下:
- 降低fn,用apolloscape数据训练centerpoint,提升模型在apolloscape数据集上的检测准确度。
- 降低fp,针对BICYCLE,PEDESTRIAN做过滤,从置信度、点云目标体积、高度差等角度过滤;【规则过滤,比较粗暴;可能会导致mota提升,map降低】
通过上述分析可知,模型检测效果,是影响mota分数的主要原因。先用模型保证高召回率,再通过规则过滤大量的fp(误检)目标,提升mota分数。针对BICYCLE,PEDESTRIAN,降低fp提升mota方法如下:
- 过滤置信度过低的目标(置信度过低,可视为误检);
- 过滤高度差小于一定阈值的目标(高度差太低,不是特定目标);
- 过滤体积小于一定阈值的目标(体积很小,非特定目标);
- 过滤车辆两旁一定距离意外的目标(例如3米以外,模拟高精地图过滤)。
插件开发
插件开发说明:https://apollo.baidu.com/community/article/1176
插件开发实践,过滤误检障碍物:https://apollo.baidu.com/community/article/1177