
CenterPoint训练指导
本教程给出了在训练过程中如何提升CenterPoint效果的相关指导意见和建议,开发者可以自行尝试并训练出更好的模型,方便快速地展开感知赛事活动。
网络训练指导
表1: 训练建议意见
建议 | 介绍 | 如何修改代码/配置configs/centerpoint/centerpoint_pillars_02voxel_apolloscape.yml |
使用预训练模型 | 我们推荐两种训练的方式:从零训练,使用预训练模型训练。 从零训练指的是网络参数随机初始化,训练初期损失较高,需要较长迭代次数损失才能降到较低的数值。 预训练模型训练指的是首先在一个大数据集上对模型进行预训练,随后在小数据集上进行finetune,属于增量训练的一种。最常见的例子,图像分类/识别领域常使用在ImageNet数据集上模型作为预训练模型,然后在较小的数据集上进行训练/finetune。采用这种方法训练初期损失较小,同时最终损失可以收敛到更小数值。 用户可以使用百度的预训练模型(使用百度自动驾驶数据训练的模型),在apolloscape数据集上进行训练,从而获得更好的效果 | 训练时添加--model的参数 |
冻结网络层 | CenterPoint网络结构如下所示,白色表示没有可学习参数,黄色表示有可学习参数 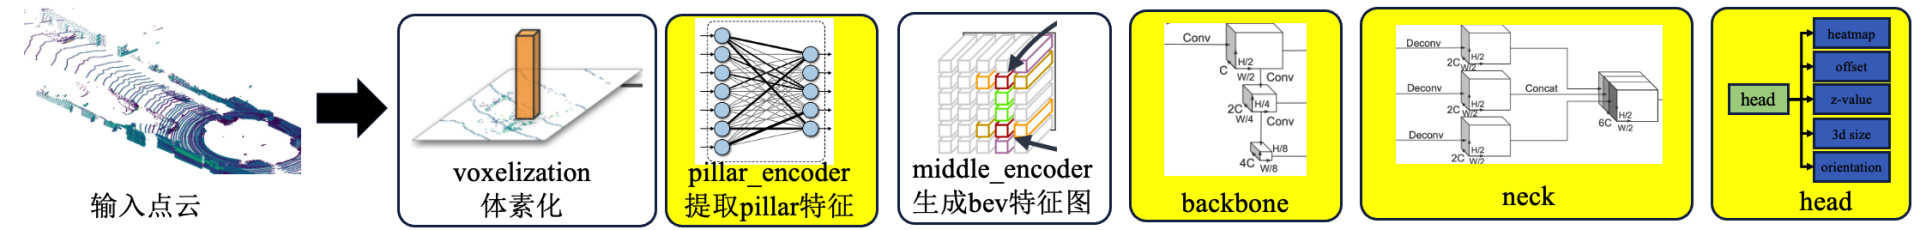 其中浅层网络例如bacbone提取的是线条、纹理等通用特征,深层网络例如head提取的更加高维的特定类别的特征。 当使用预训练模型训练时,浅层网络已经学习到了较好的通用特征,所以开发者可以冻结浅层网络,只训练finetune head的某些层,可以在保留通用特征提取能力的前提下提升当前数据集的检测效果 | |
Object Sample数据增强 | Object Sample是一种点云目标检测的数据增强手段 训练时随机添加不同类别的障碍物点云 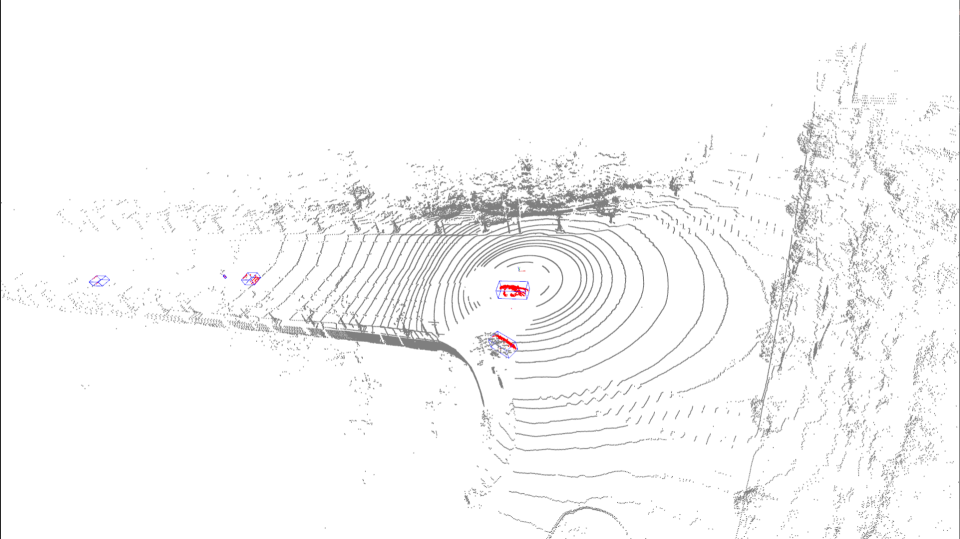 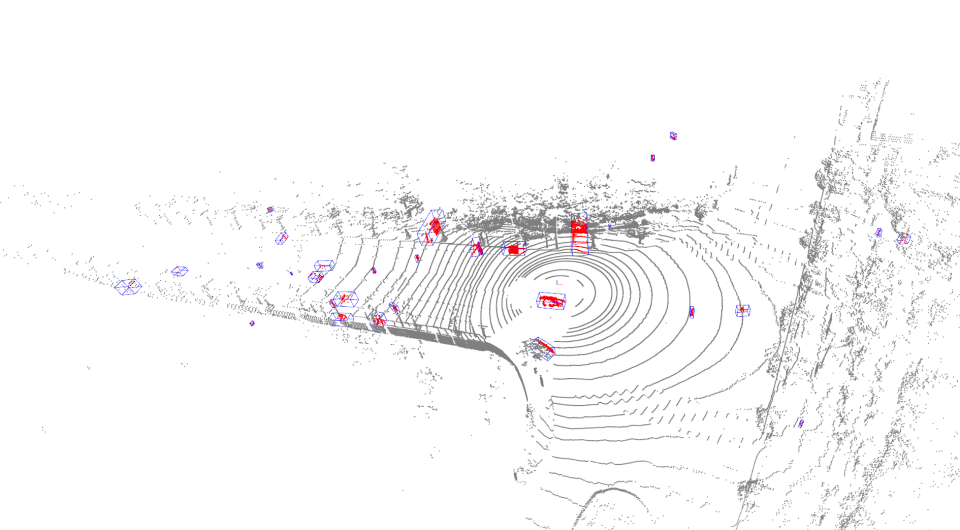 训练代码中默认开启Object Sample数据增强,开发者可以调试Object Sample的各项参数,例如有针对性地增加某种类别目标的采样数量,以此提升该类别的检测效果 | |
提升bev空间分辨率 | 训练代码中voxel_size=0.2m,降采样down_ratio为4,表示输入给head的bev特征图中每个像素的实际尺寸为0.8m*0.8m 开发者可以提升降采样down_ratio为2(或者降低voxel_size为0.1m),就可以提升BEV特征图的分辨率(每个像素的实际尺寸为0.4m*0.4m),可有效提升小目标的检测效果。 注意:这种做法会导致模型推理耗时增加。 |
|
batch_size | 一般来说,batch size越大模型效果越好 | |
epochs | 在一定范围内,epochs越大拟合程度越好;但epochs太大会有过拟合的风险 | |
学习率 | 决定了模型参数的更新速度 |
训练配置介绍
下面介绍centerpoint_pillars_02voxel_apolloscape.yml中的训练配置
基础配置
配置名称 | 默认值 | 含义 |
batch_size | 8 | 训练时一个batch包含的点云帧数 |
epochs | 5 | epoch个数 |
AMP配置 amp_cfg
自动混合精度(Automatic Mixed Precision,以下简称为 AMP)指的是在训练时使用fp16精度,提升计算速度并降低存储空间。详细介绍参考:https://www.paddlepaddle.org.cn/documentation/docs/zh/guides/performance_improving/amp_cn.html
配置名称 | 默认值 | 含义 |
use_amp | False | 是否开启amp训练 |
enable | False | - |
level | O1 | 混合精度训练的策略,可选项:O1,O2 |
scalerinit_loss_scaling | 32.0 | 控制 loss 缩放比例,规避浮点数下溢问题 |
数据集配置 train_dataset / val_datasets
配置名称 | 默认值 | 含义 | ||
type | ApolloPCDataset | 数据集类型 | ||
dataset_root | datasets/ | 数据集的路径 | ||
dataset_list | ['apolloscape'] | 数据集名称 | ||
transforms | LoadPointCloud | dim | 5 | 每个点的特征数,一般为x, y, z, intensity, timestamp |
use_dim | 4 | 使用每个点的前use_dim个特征 | ||
SamplingDatabaseV2 | min_num_points_in_box_per_class | smallMot: 20 bigMot: 20 nonMot: 10 pedestrian: 8 TrafficCone: 8 | 每种类别的目标的最少点数 | |
max_num_samples_per_class | smallMot: 10 bigMot: 10 nonMot: 10 pedestrian: 10 TrafficCone: 10 | 每帧点云中每种类别目标的最大个数 | ||
ignored_difficulty | [-1] | 困难程度限制 | ||
database_anno_list | ['apolloscape'] | 训练数据集名称 | ||
database_root | datasets | 数据集的路径 | ||
class_names | ['smallMot', 'bigMot', 'nonMot', 'pedestrian', 'TrafficCone'] | 类别信息 | ||
RandomObjectPerturb | rotation_range | [-0.15707963267, 0.15707963267] | gt随机旋转的角度范围 | |
translation_std | [0.25, 0.25, 0.25] | gt随机平移的标准差 | ||
max_num_attempts | 100 | 最大候选数量 | ||
RandomVerticalFlip | - | 开启随机竖直翻转 | ||
GlobalRotate | min_rot | -0.78539816 | 全局旋转的最小旋转角 | |
max_rot | 0.78539816 | 全局旋转的最大旋转角 | ||
GlobalScale | min_scale | 0.9 | 全局缩放的最小缩放因子 | |
max_scale | 1.1 | 全局缩放的最大缩放因子 | ||
GlobalTranslate | translation_std | [0.5, 0.5, 0.5] | 全局平移的标准差 | |
ShufflePoint | - | 打乱点云的顺序 | ||
FilterBBoxOutsideRange | point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 过滤范围外的gt | |
Gt2CenterPointTarget | tasks | num_class: 1 | centerpoint的head设置 | |
down_ratio | 4 | 下采样倍率 | ||
point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 点云范围 | ||
voxel_size | [0.20, 0.20, 8] | voxel的尺寸 | ||
gaussian_overlap | 0.1 | 高斯重叠数值 | ||
max_objs | 500 | 一帧最多允许的gt数量 | ||
min_radius | 2 | 生成heatmap时每个gt的最小半径 | ||
mode | train | 训练模式 | ||
class_balanced_sampling | False | 开启类别采样 | ||
class_names | ['smallMot', 'bigMot', 'nonMot', 'pedestrian', 'TrafficCone'] | 类别信息 | ||
优化器配置 optimizer
配置名称 | 默认值 | 含义 | |
type | OneCycleAdam | 优化器类型 | |
beta2 | 0.99 | beta2 | |
weight_decay | 0.01 | 衰减系数 | |
grad_clip | type | ClipGradByGlobalNorm | 梯度裁剪 |
clip_norm | 35 | ||
beta1 | type | OneCycleDecayWarmupMomentum | 动量设置 |
momentum_peak | 0.95 | ||
momentum_trough | 0.85 | ||
step_ratio_peak | 0.4 | ||
学习率设置 lr_scheduler
配置名称 | 默认值 | 含义 |
type | OneCycleWarmupDecayLr | 学习率类型 |
base_learning_rate | 0.0001 | 初始学习率 |
lr_ratio_peak | 10 | 最大学习率的比例因子 |
lr_ratio_trough | 0.0001 | 最小学习率的比例因子 |
step_ratio_peak | 0.4 | 到达最大值的step比例 |
模型配置 model
配置名称 | 默认值 | 含义 | |
type | CenterPoint | 模型名称 | |
voxelizer | type | HardVoxelizer | 体素化方法 |
point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 点云范围 | |
voxel_size | [0.20, 0.20, 8] | voxel尺寸 | |
max_num_points_in_voxel | 20 | 每个voxel中最多的点数 | |
max_num_voxels | [30000, 60000] | 训练/推理时voxel数量 | |
voxel_encoder | type | PillarFeatureNet | voxel_encoder名称 |
in_channels | 4 | 输入的channel数量 | |
feat_channels | [64, 64] | fc层的输出channel | |
with_distance | False | 是否使用distance特征 | |
max_num_points_in_voxel | 20 | 每个voxel中最多的点数 | |
voxel_size | [0.20, 0.20, 8] | voxel尺寸 | |
point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 点云范围 | |
middle_encoder | type | PointPillarsScatter | middle_encoder名称 |
in_channels | 64 | 输入channel数量 | |
voxel_size | [0.20, 0.20, 8] | voxel尺寸 | |
point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 点云范围 | |
backbone | type | SecondBackbone | backbone名称 |
in_channels | 64 | 输入channel | |
out_channels | [64, 128, 256] | 每个stage的输出channel | |
layer_nums | [3, 5, 5] | 每个stage的卷积层个数 | |
downsample_strides | [2, 2, 2] | 每个stage的降采样步长 | |
neck | type | SecondFPN | neck名称 |
in_channels | [64, 128, 256] | 输入channel | |
out_channels | [128, 128, 128] | 输出channel | |
upsample_strides | [0.5, 1, 2] | 上采样步长 | |
use_conv_for_no_stride | True | 是否在未上采样处使用卷积层 | |
bbox_head | type | CenterHead | head名称 |
in_channels | 384 | 输入channel | |
tasks | - num_class: 1 class_names: ["smallMot"] - num_class: 1 class_names: ["bigMot"] - num_class: 1 class_names: ['nonMot'] - num_class: 1 class_names: ['pedestrian'] - num_class: 1 class_names: ['TrafficCone'] | head设置 | |
weight | 0.25 | 定位损失的权重 | |
code_weights | [1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0] | 8种定位属性的权重 | |
common_heads | reg: [2, 2] height: [1, 2] dim: [3, 2] rot: [2, 2] | 4种head的设置 | |
test_cfg | post_center_limit_range | [-90., -90., -10., 90., 90., 10.] | dt center的范围 |
nms_pre_max_size | 1000 | nms之前的dt数量 | |
nms_post_max_size | 83 | nms之后的dt数量 | |
nms_iou_threshold | 0.2 | nms iou阈值 | |
score_threshold | 0.5 | 置信度阈值 | |
point_cloud_range | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] | 点云范围 | |
down_ratio | 4 | 下采样倍率 | |
voxel_size | [0.20, 0.20, 8] | voxel尺寸 | |
